

 SЕalytics (SEO-аналити...
 Хорошие SEO шники - ка...
 Мэ́джик | SEO, AI и са...
 SEOделов
 Около SEO | Артёменко ...
 Палыч про SEO
 SEO для сайтов услуг -...
 ChatGPT, AI, Python дл...
 Заметки SEOшника
 SEO - Продукт и Аналит...
 Нейросетевой SEOшник
 SEO Фишки
 SiteAnalyzer
 Смотри, SEO работает
 SEO-Де́бри
 SEO-специалисты
 SEO-компании
 Стена
 Данные раскрывают реальный лимит: Гугл виснет на сайтмапах...
 Mike Blazer
 41
Данные раскрывают реальный лимит: Гугл виснет на сайтмапах задолго до 50K файлов — потолок около 200
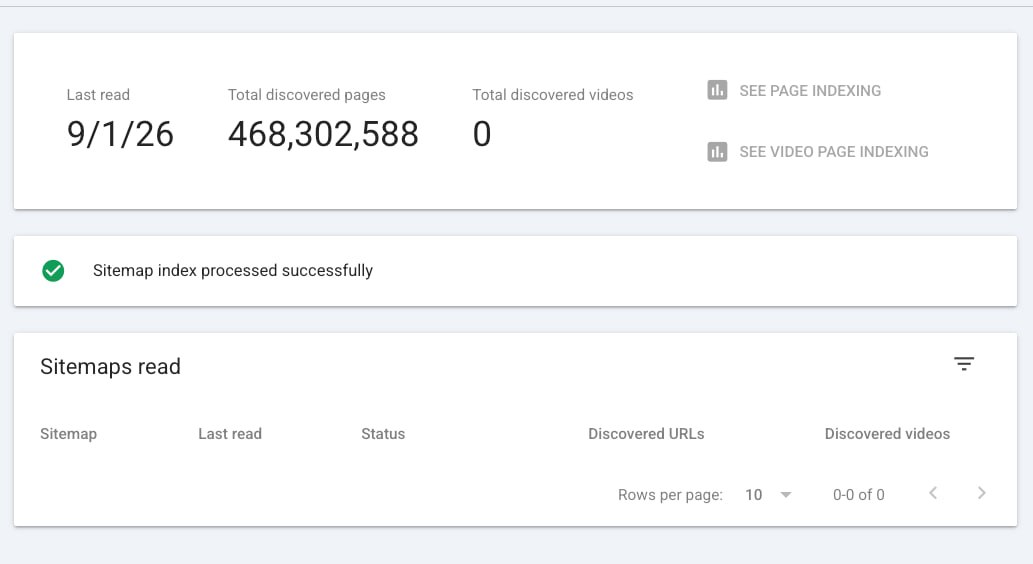
Индексный сайтмап на 19 000 вложенных файлов для сайта с 1 млрд урлов так и не обработался и показал ноль вложенных карт спустя месяц.
Каждый файл вписывался в официальные лимиты: вес до 50 МБ без сжатия, до 50К урлов на файл, меньше 50К вложенных карт на индекс.
Bing парсил тысячи вложенных файлов в день из тех же исходников; Гугл скраулил около 20 за весь месяц.
Раньше этот сетап работал без сбоев — до августа проблем не было на чуть меньшем объеме урлов, затем сайтмап пробил 900 млн, но так и не смог переварить 950 млн, а теперь даже срез на 95 млн обрабатывается со скрипом.
Диагноз сводится к масштабам обработки, а не к формату сайтмапа.
Мелкие индексы работают, тогда как индексы на 5К+ файлов виснут наглухо — это указывает на скрытый лимит или на то, что GSC захлебывается от размера файла даже в рамках официальных ограничений.
Сразу несколько тредов в справке Гугла за май-август описывают тот же сбой: валидные сайтмапы, которые гуглобот может парсить, но GSC их тупо не обрабатывает, либо обрабатывает лишь частично:
Единственный способ нащупать реальный потолок — это ступенчатое тестирование.
Оставляешь всё остальное без изменений и шагами урезаешь родительский индекс: 10 вложенных файлов, затем 50, затем 100 и так далее, параллельно мониторя серверные логи на предмет парсинга сайтмапов гуглоботом.
Если 100 файлов залетают нормально, а на 500 всё виснет, то это и есть фактический порог, что бы там ни писали про официальные 50К.
Срезы говорят сами за себя.
Индексы размером до 5К файлов фиксировали по одной вложенной карте и останавливались.
Индекс всего на 10 файлов Гугл обработал полностью за пару минут.
Что в итоге сработало: 100 индексных файлов, в каждом меньше 200 вложенных сайтмапов — они залетели в панель за считанные минуты, и гуглобот начал их парсить.
Тестировали не каждый шаг, поэтому больший размер индекса тоже может прокатить; точный потолок так и остался нераскрытым.
Инсайты комьюнити
— Гуглобот продолжал краулить сайт со скоростью 1-5 млн хитов в день всё то время, пока висел сайтмап. Такой стабильный объем парсинга указывает на то, что проблема именно в неспособности гуглобота переварить файлы сайтмапа, а не в урезании краулингового бюджета для самого сайта.
— Правило ожидания при тестах индексации: для индекса на 1000+ файлов закладывай неделю, или две, если хочешь перестраховаться. Если индекс на 5К файлов спустя это время так и висит с одним обработанным файлом, то это, скорее всего, проваленный тест на индексацию, а не нормальная задержка.
— Структурные альтернативы одному гигантскому индексу: дробить индексные файлы по подпапкам или завести отдельный ресурс в GSC под каждую подпапку и скармливать их отдельно. GSC ограничивает один ресурс 500 индексными файлами, но сабмитить ~1900 крошечных индексов нет смысла — разбить единый индекс на 5 или 10 индексных файлов куда логичнее (на этом сайте 5 файлов всё равно зависли; потребовалось 100).
— Смежный пост по GSC-аналитике, который стоит изучить: https://www.linkedin.com/posts/ajkohn_gsc-analytics-ugcPost-7502749443960672256-Fxta
— Цифра в 468 млн "обнаруженных" урлов в GSC, зависшая на месяц примерно на половине от общего объема, считает только те урлы, которые Гугл вытащил из сайтмапа, а не скраулил или проиндексировал.
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
– https://theseocommunity.slack.com/archives/C05JKJD...
– https://t.me/MikeBlazerX
– https://t.me/tribute/app?startapp=sE4X
Источник новости https://t.me/mikeblazerx/6780...
ТОП каналов по SEO 
 Дежурный SEO-доктор
 SEO канал Shakin.ru
 Про SEO и заработок на...
 DrMax SEO
 Англоязычное SEO
 SEO от Анны Ященко
 SEO ETC
 SeoForge
 SEO, маркетинг и бизне...
 АлаичЪ
 Лайфхаки по SEO
Последние интересные посты