

 SЕalytics (SEO-аналити...
 Хорошие SEO шники - ка...
 Мэ́джик | SEO, AI и са...
 SEOделов
 Около SEO | Артёменко ...
 Палыч про SEO
 SEO для сайтов услуг -...
 ChatGPT, AI, Python дл...
 Заметки SEOшника
 SEO - Продукт и Аналит...
 Нейросетевой SEOшник
 SEO Фишки
 SiteAnalyzer
 Смотри, SEO работает
 SEO-Де́бри
 SEO-специалисты
 SEO-компании
 Стена
 Модели контекстных эмбеддингов обходят старые ретриверы &mdash...
 Mike Blazer
 12
Модели контекстных эмбеддингов обходят старые ретриверы — изолированные чанки для GEO больше не нужны
Советы по GEO продавливают одно правило: делай каждый чанк самостоятельным.
Если переписывать каждый абзац, повторяя бренд и продукт, это поможет только тем ретриверам, которые сейчас активно вымирают, документирует Ян-Виллем Боббинк.
У этого совета есть реальная база.
В 2023 году Chen et al. доказали: плотные ретриверы находят ответы точнее, если индексировать Википедию как мелкие самодостаточные утверждения, а не куски по 100 слов.
Это работает для любой системы, которая кодирует каждый чанк отдельно.
Фраза "доход компании вырос на 3%" ничего не скажет ретриверу, если её оторвать от абзаца с названием бренда.
С тех пор исследования поиска атаковали ту же проблему с другой стороны:
— Anthropic заставил LLM писать короткую строку контекста перед каждым чанком и срезал сбои поиска на 49%.
— Jina выкатила late chunking, который кодирует весь документ до его разбивки на чанки.
— Исследование ConTEB раскрывает: если удалить сущность из абзаца, стандартный поиск рушится, тогда как контекстные модели этого почти не замечают.
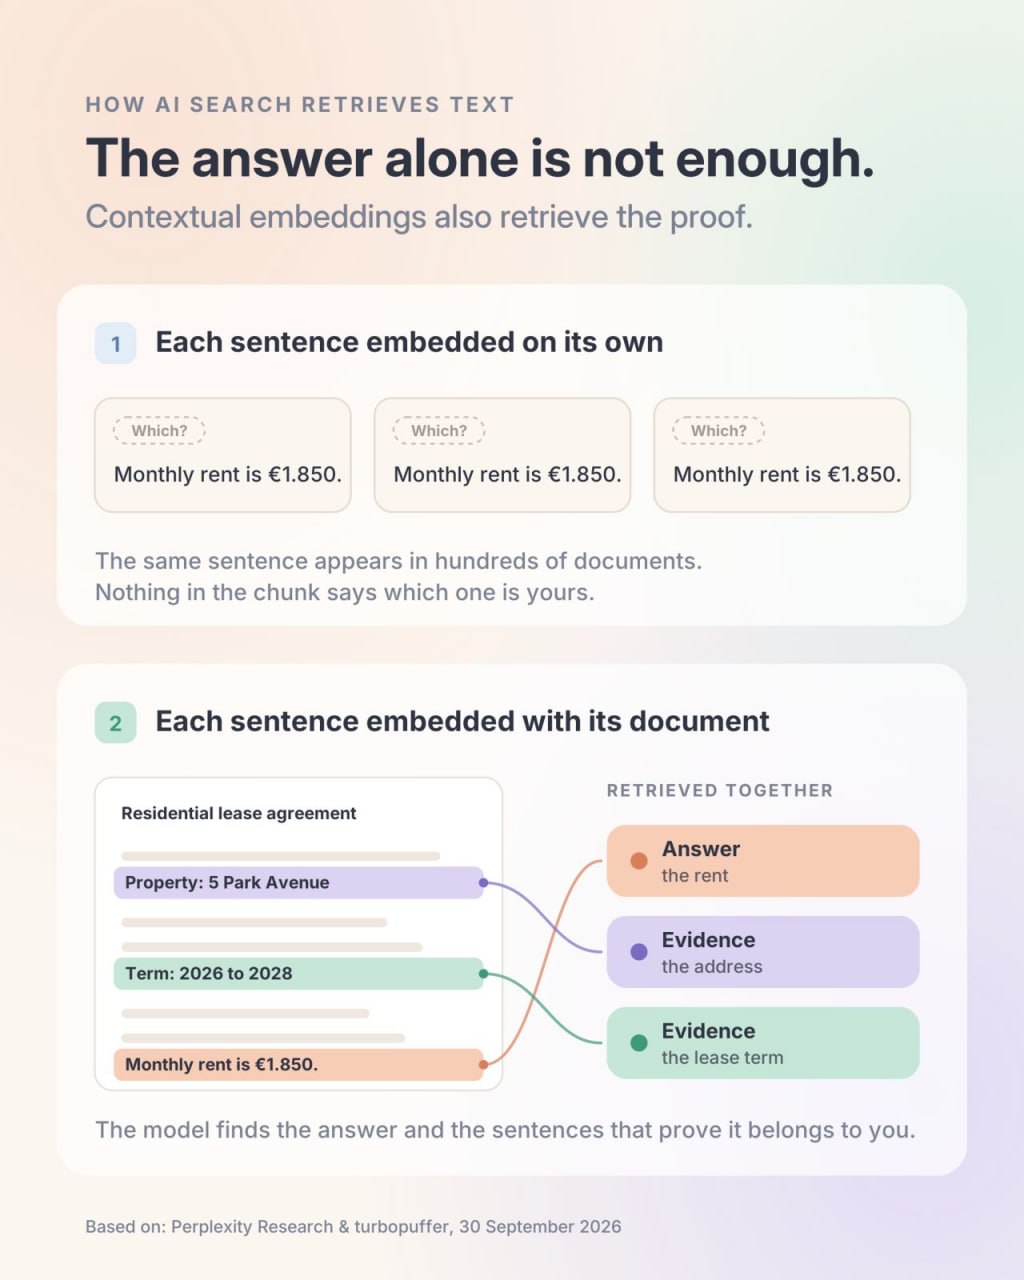
30 сентября Perplexity и turbopuffer опубликовали следующий шаг: модель контекстных эмбеддингов, натренированную извлекать предложение-ответ вместе с теми предложениями, которые доказывают его принадлежность к правильному документу.
Бенчмарк прогоняет 2,099 запросов через 38,894 длинных документа, разбитых на 2,458,072 чанков-предложений.
Базу намеренно засеяли почти идентичными текстами — вроде договоров аренды, где одна и та же фраза про плату дублируется в куче файлов.
В топ-10 модель нашла ответ для 45.5% запросов и вытянула 40.6% подтверждающих данных.
Контекстной модели нужны доказательства где-то в том же документе: к какой сущности, версии, рынку и дате относится ответ — потому что она подтягивает эти предложения вместе с ответом.
По этой логике, следующая связка делает больше работы, чем принудительное переписывание:
— Четкие заголовки таблиц
— Тематические заголовки разделов
— Явная строка о том, к кому или чему относится страница
Самодостаточный текст никуда не уходит: пайплайны, которые кодируют чанки независимо, всё ещё в ходу, а понятное предложение ничего не стоит.
Полевые наблюдения относят большинство продакшен-стеков к лагерю "разбить до эмбеддинга", где строка с доказательством всё равно никогда не путешествует вместе с чанком.
У этих данных есть жёсткие лимиты:
— Исследование вендора на превью-модели
— Приватный бенчмарк, запущенный совместно с turbopuffer
— В анонсе нет ни слова о том, что эта модель сегодня работает в движке ответов Perplexity
— Даже эта модель не находит ответ в топ-10 для более чем половины запросов
Это указывает направление, а не результат, уже проверенный на клиентских сайтах.
Инсайты комьюнити
— Полевое внедрение столкнулось с просадкой в классической органике после слишком жесткой зачистки "маркетинговой воды" ради конкретики. Гипотеза: если каждая страница выдает один и тот же набор фактов, именно специфичные детали бренда делают её уникальной в глазах Google.
— Тесты в реальных условиях подтверждают то же самое для LLM: размытый текст или раскиданные по странице детали снижают уверенность механизма внимания в том, какая информация связана между собой. Любое многозначное слово требует уточняющих маркеров ("practice" может быть спортивной, юридической или медицинской), а фраза "доказательства говорят сами за себя" над блоком с наградами не дает LLM ничего для работы.
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
– https://www.linkedin.com/posts/jbobbink_seo-geo-pe...
– https://t.me/MikeBlazerX
– https://t.me/tribute/app?startapp=sE4X
Источник новости https://t.me/mikeblazerx/6799...
ТОП каналов по SEO 
 Дежурный SEO-доктор
 SEO канал Shakin.ru
 Про SEO и заработок на...
 DrMax SEO
 Англоязычное SEO
 SEO от Анны Ященко
 SEO ETC
 SeoForge
 SEO, маркетинг и бизне...
 АлаичЪ
 Лайфхаки по SEO
Последние интересные посты