

 SEOделов
 Около SEO | Артёменко ...
 Палыч про SEO
 SEO для сайтов услуг -...
 ChatGPT, AI, Python дл...
 Заметки SEOшника
 SEO - Продукт и Аналит...
 Нейросетевой SEOшник
 SEO Фишки
 SiteAnalyzer
 Смотри, SEO работает
 SEO-Де́бри
 SEO ETC
 SEO, Я.Директ & Маркет...
 Hello, Digital World
 SEO-специалисты
 SEO-компании
 Стена
 Патент Google Visual Citations раскрывает механику: совпадение...
 Mike Blazer
 3
Патент Google Visual Citations раскрывает механику: совпадение по картинке перевешивает текст при выборе источника
Патент, поданный в 2023 году и опубликованный в апреле 2026-го, описывает флоу генерации ответа.
Алгоритм сначала выбирает источник по совпадению картинки, а уже потом подтягивает окружающий текст для формирования ответа.
Это лишь заявка, а не подтвержденная механика в проде.
Google регистрирует их тысячами, и многие никогда не выходят в прод в описанном виде.
Если рассматривать это как вектор развития, а не как факт, патент переворачивает все правила, на которых строилось image SEO.
Картинка решает, какая страница попадет в ответ, а текст рядом с этой картинкой решает, что именно скажет ответ.
Операционное следствие — это плейсмент.
Факт, нужный покупателю, должен висеть прямо под картинкой в виде подписи или тега, а не в трех скроллах ниже по странице.
Распознавание не гарантировано.
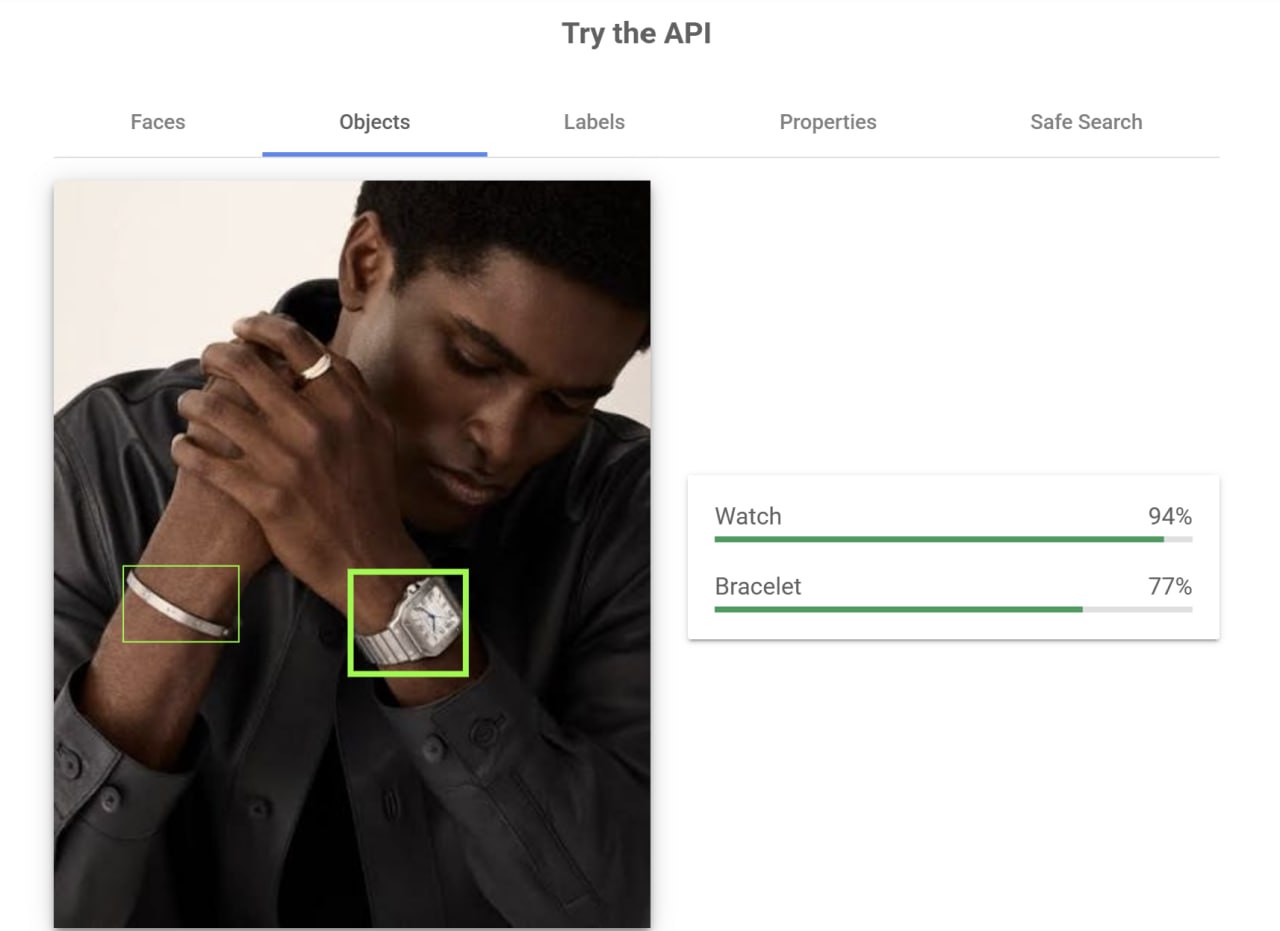
На одном из рекламных кадров Cartier модель компьютерного зрения выдала браслет и часы, но в упор не заметила кольцо.
То, что креативная команда пыталась донести, и то, что фиксирует алгоритм — это разные сущности.
И только вторая попадает в движок ответов.
Текст на картинке отваливается при измеримых условиях.
Пороги отказа, вытянутые из литературы Cognex и arXiv, а не из спецификаций Google, показывают: OCR ломается при высоте символов ниже ~30px, контрасте менее ~40 оттенков серого, на стилизованных шрифтах и бликах от отражающей упаковки.
Сжатие, заточенное исключительно под скорость загрузки, вычищает текст с упаковки, который модель должна была спарсить.
Большую часть слоя измерений берет на себя Google Cloud Vision API:
— Web Detection отдает fullMatchingImages, partialMatchingImages, visuallySimilarImages и pagesWithMatchingImages. Это проверка на уникальность: реально ли hero image принадлежит вам, или это около-дубль, который юзает половина ниши.
— OBJECT_LOCALIZATION возвращает названия найденных объектов, mid-идентификаторы, скоринг уверенности алгоритма (confidence) и координаты (bounding boxes). Это дает список объектов-соседей в кадре, чтобы контролировать совместную встречаемость по бренд-гайдлайнам. Сам по себе API контекст не оценивает.
— TEXT_DETECTION прогоняет OCR-слой, отвечающий за метрику читаемости.
— FACE_DETECTION отдает faceAnnotations и классификаторы эмоций от UNKNOWN до VERY_UNLIKELY, UNLIKELY, POSSIBLE, LIKELY и VERY_LIKELY (где VERY_LIKELY — это таргет). Отсечка по confidence: 0.90 и выше — железобетонно, 0.70-0.89 — сойдет для второстепенных кадров, все, что ниже 0.60 — это мусор.
— Масштабирование проверки идет через Screaming Frog плюс OpenAI Vision API и остается качественным. Связка флагит запросы, которые страница уже могла бы забрать, если бы ее текст подтверждал то, что нарисовано на фото.
За этими цифрами стоят два вопроса.
Первый: правильно ли машина прочитала то, что в кадре?
И второй: правильный ли объект туда вообще засунули на старте?
Первое — это слой денотации, который можно чекнуть на уровне объектов.
Второе — слой коннотации: проблема брифинга, которую не закроет ни один API.
https://searchengineland.com/images-new-job-ai-search-485840
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
– https://t.me/MikeBlazerX
– https://t.me/tribute/app?startapp=sE4X
Источник новости https://t.me/mikeblazerx/6703...
ТОП каналов по SEO 
 Дежурный SEO-доктор
 SEO канал Shakin.ru
 Про SEO и заработок на...
 DrMax SEO
 Англоязычное SEO
 SEO от Анны Ященко
 SeoForge
 SEO, маркетинг и бизне...
 АлаичЪ
 Лайфхаки по SEO
Последние интересные посты