

 Мэ́джик | SEO, AI и са...
 SEOделов
 Около SEO | Артёменко ...
 Палыч про SEO
 SEO для сайтов услуг -...
 ChatGPT, AI, Python дл...
 Заметки SEOшника
 SEO - Продукт и Аналит...
 Нейросетевой SEOшник
 SEO Фишки
 SiteAnalyzer
 Смотри, SEO работает
 SEO-Де́бри
 SEO ETC
 SEO, Я.Директ & Маркет...
 SEO-специалисты
 SEO-компании
 Стена
 Я отдал все выходные на группировку семантического ядра
 12
Я отдал все выходные на группировку семантического ядра
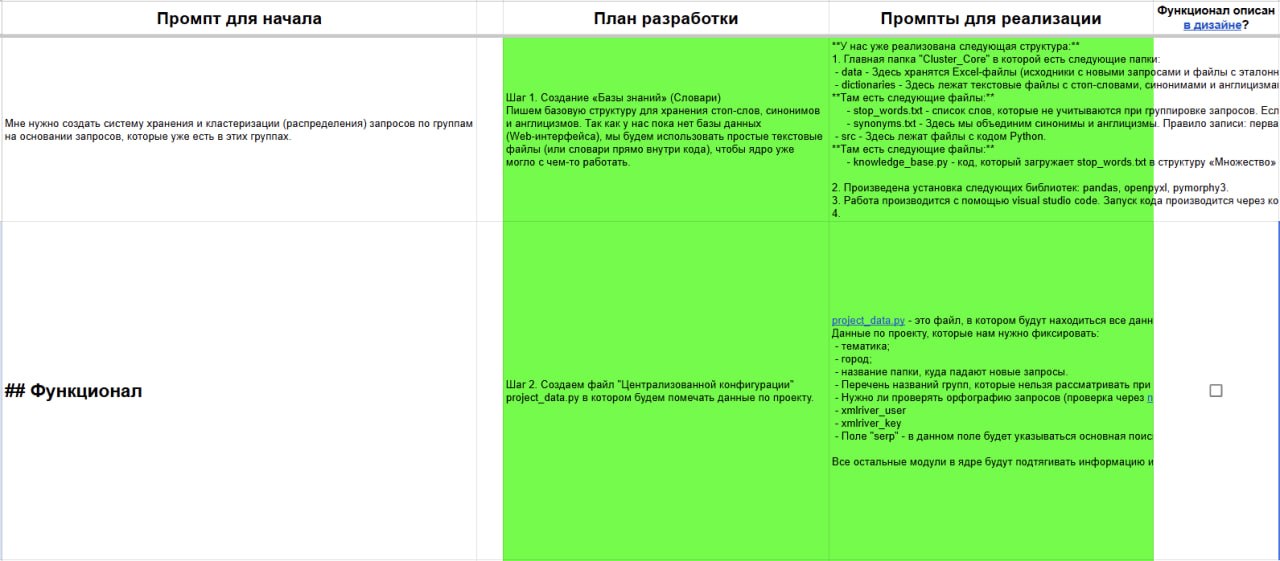
И понял, что трачу своё время не туда, разделив по нужным группам всего 4000 запросов. Это было примерно год назад, и именно тогда я решил создать автоматическую систему распределения запросов по нужным группам для личного пользования.
Распределение запросов по группам нужно для того, чтобы находить новые страницы для создания, а также улучшать оптимизацию своих страниц под новые запросы.
Чтобы автоматизировать такой сложный процесс, пришлось забыть все базовые правила по сбору семантики, которые я знал до этого, и изучить их заново, но под другим углом.
Создавая эту программу, я старался вести некий дневник, на основании которого составил серию постов. Я решил опубликовать посты не из серии «посмотрите, что я создал», а скорее рассказать про новый взгляд на сбор семантического ядра от специалиста, который делал это хорошо (и даже любил засесть и потратить на это 4–5 часов безвылазно), но захотел полностью переложить знания в математический алгоритм, чтобы пойти дальше.
В итоге:
• Инвестировано (не люблю слово «потрачено»): более 240 часов на создание
• Изучено: около 40 статей и 10 видео
Я не смогу описать всю логику — это сложно, да и не нужно никому. Я постараюсь писать посты так, чтобы даже те, кто собирает запросы вручную, могли извлечь что-то полезное из каждого поста.
🎁 И чтобы этот пост тоже был полезен, дарю универсальный список стоп-слов для определения информационных запросов →
Ссылки из поста:– https://docs.google.com/spreadsheets/d/1_UJvsVmQJp...
Источник новости https://t.me/digitalalekzo/546...
ТОП каналов по SEO 
 Mike Blazer
 Дежурный SEO-доктор
 SEO канал Shakin.ru
 Про SEO и заработок на...
 DrMax SEO
 Англоязычное SEO
 SEO от Анны Ященко
 SeoForge
 SEO, маркетинг и бизне...
 АлаичЪ
 Лайфхаки по SEO
Последние интересные посты
 У Карпаты вышел интере...