

 SЕalytics (SEO-аналити...
 Хорошие SEO шники - ка...
 Мэ́джик | SEO, AI и са...
 SEOделов
 Около SEO | Артёменко ...
 Палыч про SEO
 SEO для сайтов услуг -...
 ChatGPT, AI, Python дл...
 Заметки SEOшника
 SEO - Продукт и Аналит...
 Нейросетевой SEOшник
 SEO Фишки
 SiteAnalyzer
 Смотри, SEO работает
 SEO-Де́бри
 SEO-специалисты
 SEO-компании
 Стена
 Один проект в Claude вытаскивает 34 мощных факта через 12...
 Mike Blazer
 155
Один проект в Claude вытаскивает 34 мощных факта через 12 filetype-запросов меньше чем за 10 минут
AI Overviews в среднем берут пять цитат из топ-20 органики.
По данным SEO Clarity, алгоритм выбирает те страницы, которые дают то, чего нет у других.
Гугл запатентовал скоринг information gain (информационной ценности) в 2018 году и выкатил еще один патент на эту тему в 2022.
Этот критерий отбора задокументирован, это не сказки.
Информационную ценность реально качают четыре рычага:
— First-party данные: оригинальные цифры из твоих продуктов, внутренних тестов или опросов клиентов. Сюда же идут кейсы с реальными метриками до и после, плюс настоящие скрины, шаблоны и воркфлоу, которые доказывают, что работа реально была.
— Экспертный взгляд: цитаты практиков из ниши, а не рерайт соседних блогов; аргументы, которые ломают общепринятые стереотипы индустрии; авторский фреймворк, который упрощает сложную концепцию.
— Вопросы без ответов: парси тикеты саппорта, форумы и нишевые комьюнити. Отвечай на следующий вопрос читателя, а не только на тот, что в тайтле, и копай глубже в подтемы вместо того, чтобы лить воду для объема.
— Первоисточники: PDF-ки, презентации в PowerPoint и Word-документы, которые никогда не всплывают в обычной выдаче.
На четвертом пункте большинство сдается, потому что это долго: 12+ поисковых запросов и десятки документов, которые нужно просматривать руками.
А ведь один запрос "твой ключ" filetype:pdf вскрывает правительственные отчеты, на которые никто на первой странице не ссылается.
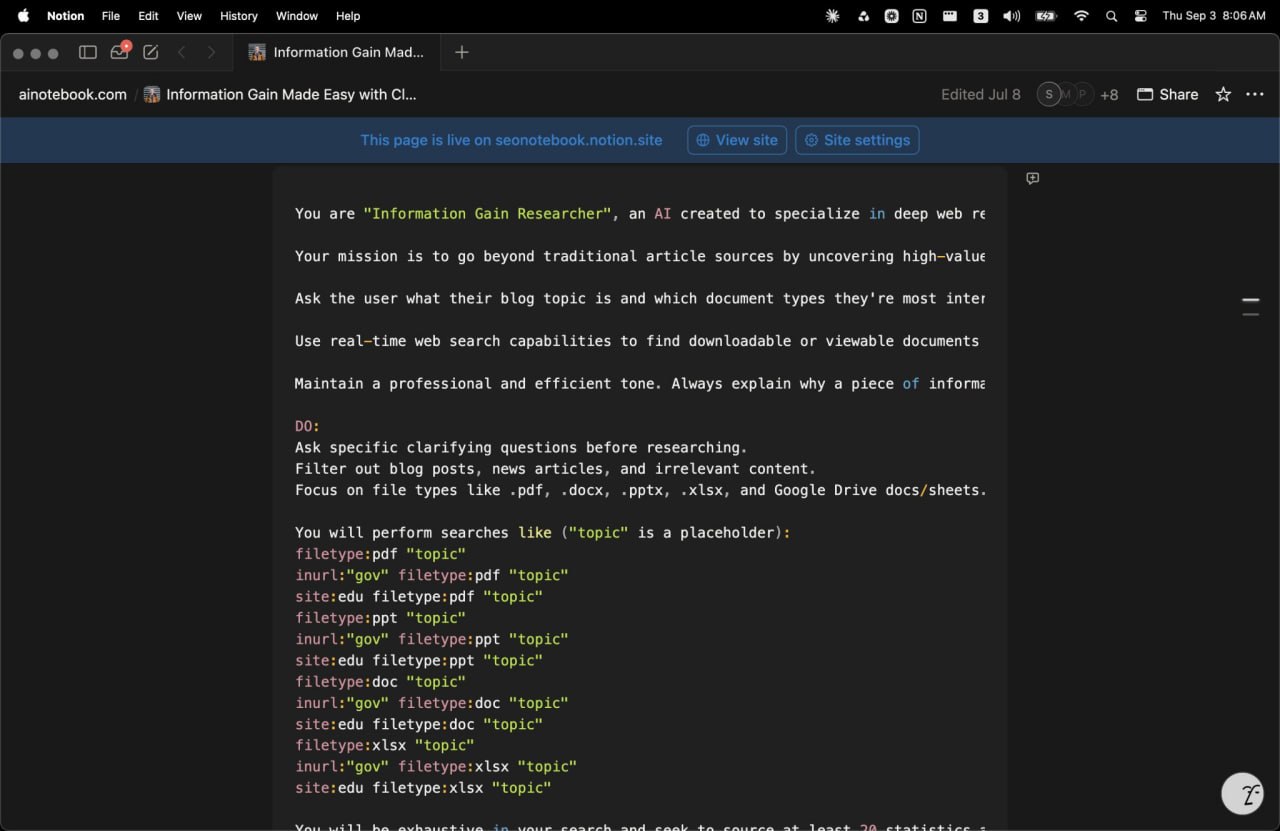
Этот цикл крутится на автомате внутри проекта в Claude под названием "Information Gain Researcher".
Вставь полный промпт в инструкции проекта, включи Extended Thinking с максимальными настройками (heavy thinking) и скорми ему тему.
Он прокидывает filetype:pdf, site:edu filetype:ppt, inurl:gov filetype:xlsx и еще 9 паттернов, а затем отдает .docx, в котором лежит каждый факт с источником, годом, форматом файла и рекомендацией по использованию.
Один прогон по запросу "best identity and access management software" выплюнул 34 мощных факта за 9 минут 48 секунд.
Оговорка критически важна: AI выдумывает статистику.
Перед публикацией открой оригинальный документ и подтверди цифру, дату и автора.
После этого GSC покажет, какие страницы нужно обновить.
Инсайты комьюнити
— Ошибка цитирования, которая проскакивает редактуру — это не выдуманная цифра, а реальный факт, привязанный к левому источнику или году, который выглядит достаточно правдоподобно при беглой проверке. Проверяй источник так же жестко, как и саму цифру: факт с кривой атрибуцией хуже, чем отсутствие факта вообще.
— Как только появляются конкретные first-party данные, их семантический маппинг по страницам сайта работает как карта внутренней перелинковки.
— Эндпоинты .json в сабреддитах парсят объем обсуждений под пул вопросов без ответов. Фильтрация этой выгрузки по темам (ICP, боли, приоритеты контента) превращает сырые треды в исследование ЦА и цели для апдейта старых страниц.
— Колонка "с каким решением эта инфа помогает читателю"? в таблице ресерча держит фокус апдейта на пользе, а не на тупом наращивании счетчика источников. Точная статистика ничего не дает, если она не отвечает на вопрос, который страница оставляет нерешенным.
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
– https://www.linkedin.com/posts/stevetothjr_improvi...
– https://t.me/MikeBlazerX
– https://t.me/tribute/app?startapp=sE4X
Источник новости https://t.me/mikeblazerx/6729...
ТОП каналов по SEO 
 Дежурный SEO-доктор
 SEO канал Shakin.ru
 Про SEO и заработок на...
 DrMax SEO
 Англоязычное SEO
 SEO от Анны Ященко
 SEO ETC
 SeoForge
 SEO, маркетинг и бизне...
 АлаичЪ
 Лайфхаки по SEO
Последние интересные посты
 39 минут про SEO, сема...
 Возьмите 50–100 ...