

 SЕalytics (SEO-аналити...
 Хорошие SEO шники - ка...
 Мэ́джик | SEO, AI и са...
 SEOделов
 Около SEO | Артёменко ...
 Палыч про SEO
 SEO для сайтов услуг -...
 ChatGPT, AI, Python дл...
 Заметки SEOшника
 SEO - Продукт и Аналит...
 Нейросетевой SEOшник
 SEO Фишки
 SiteAnalyzer
 Смотри, SEO работает
 SEO-Де́бри
 SEO-специалисты
 SEO-компании
 Стена
 Бесплатный скрипт для Google Sheets вытягивает чистый текст по...
 Mike Blazer
 67
Бесплатный скрипт для Google Sheets вытягивает чистый текст по списку URL без краулеров
Основной текст из списка урлов можно закинуть в таблицу и без лицензии на Screaming Frog или Sitebulb.
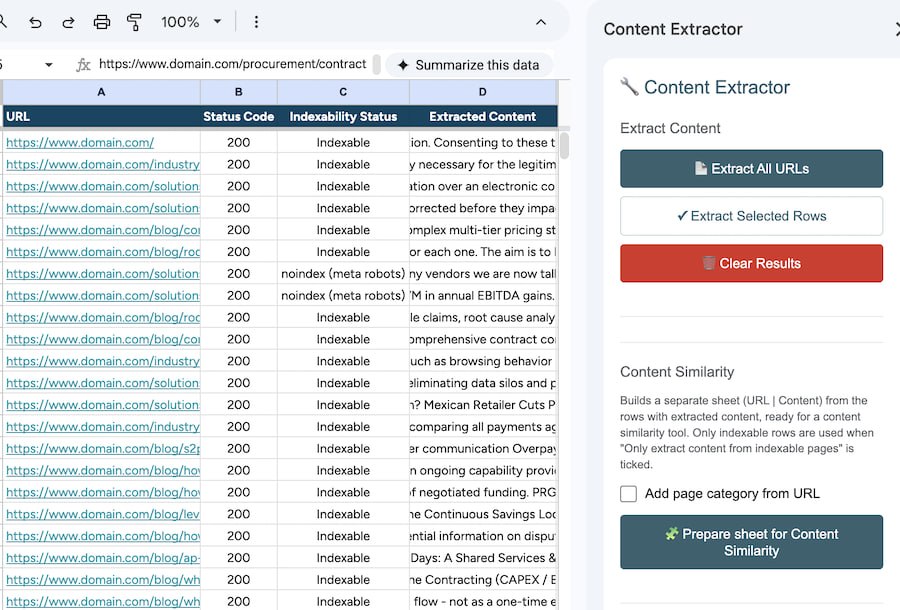
Content Extractor решает эту задачу в виде Apps Script внутри Google Sheets — инструмент написан для аудитов, когда под рукой нет краулера.
Скрипт читает урлы из колонки A начиная со второй строки.
После запуска Extract All URLs главный контент каждой страницы из исходного HTML падает в колонку D.
В колонку B выводится код статуса, а в C — статус индексации (с причиной, если страница закрыта).
Фильтрация колонки C по условию "Текст начинается с" Non-indexable моментально изолирует проблемные урлы.
Парсер вычищает скрипты, стили, скрытые элементы, а также хедер, навигацию и футер сайта, включая любые блоки, у которых в имени класса есть header, nav или footer.
По умолчанию парсер отбрасывает текстовые фрагменты короче 20 символов (например, кнопки и лейблы); порог настраивается в боковой панели.
Чтобы снести любой другой блок, например куки-баннер, закинь его открывающий тег в Custom Exclusions: <div class="cookie-banner"> удалит всё внутри.
Скрипт фетчит страницы по одной с небольшой паузой — примерно 20–40 урлов в минуту.
Сайдбар обрабатывает длинные списки пачками.
Каждый прогон укладывается в 6-минутный лимит скриптов Google, поэтому таблица продолжает парсить данные до тех пор, пока панель открыта.
Бесплатные аккаунты Gmail режут суточные фетчи примерно на 20 000, в Workspace лимит выше.
Код можно редактировать через Extensions → Apps Script.
Стейджинг и сайты под паролем пробиваются через Basic Auth, Bearer-токен или заголовок с API-ключом.
Все доступы задаются в боковой панели; они приватно хранятся в Google-аккаунте, передаются только по HTTPS и только на разрешенные домены.
Для аудитов на каннибализацию опция Prepare sheet for Content Similarity экспортирует CSV для бесплатного инструмента Content Cannibalization Tool, который находит пересечения в контенте.
Выхлоп искажают четыре слепых пятна:
— Никакого рендера JavaScript: контент, который подгружается только после отработки скриптов, приходит пустым или почти пустым.
— Скрипт не ходит по редиректам: урл без закрывающего слеша или на http вместо https отображается как перенаправленный, а не спарсенный, поэтому в список нужно закидывать только финальные урлы.
— Игнор robots.txt: закрытая в нем страница всё равно может получить статус Indexable.
— Защита от ботов: таблица стучится с серверов Google и представляется как Google Apps Script. Фаерволы и антибот-системы могут разворачивать такие запросы, обычно отдавая 403 или 429 ошибку.
Статус 200 — тоже не доказательство наличия контента.
Иногда блокировка отдает 200-й ответ с капчей (challenge page).
Верный признак этого — когда спарсенный текст слишком короткий или вообще не относится к странице.
https://docs.google.com/spreadsheets/d/1VvGB4AeUM4oUpCzw4xW3jtCsPHrGAMv9J6O8EKKGKdM/edit?gid=0#gid=0
https://addonist.com/tools/content-extractor/
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
– https://t.me/MikeBlazerX
– https://t.me/tribute/app?startapp=sE4X
Источник новости https://t.me/mikeblazerx/6852...
ТОП каналов по SEO 
 Дежурный SEO-доктор
 SEO канал Shakin.ru
 Про SEO и заработок на...
 DrMax SEO
 Англоязычное SEO
 SEO от Анны Ященко
 SEO ETC
 SeoForge
 SEO, маркетинг и бизне...
 АлаичЪ
 Лайфхаки по SEO
Последние интересные посты
 Все хотят ссылок с тра...